خدمات سخت افزاری ویژه شرکت ها و سازمان ها
تعمیر سخت افزار کامپیوتر و سرور؛ پشتیبانی، عیب یابی و نگهداری
عیب یابی و پشتیبانی سخت افزاری کامپیوتر، سرور و تجهیزات IT با بررسی قطعات، رفع خرابی، ارتقا و تعویض قطعات مورد نیاز سازمان
- عیب یابی سخت افزار
- تعمیر و تعویض قطعات
- پشتیبانی سرور و کامپیوتر
- امکان بررسی تجهیزات در محل
تعمیر سخت افزار کامپیوتر و سرور چیست؟
تعمیر سخت افزار کامپیوتر و سرور مجموعه خدمات تشخیص خرابی، بررسی سلامت قطعات، تعمیر یا تعویض قطعه معیوب و تست عملکرد دستگاه است. این خدمات قطعاتی مانند مادربرد، پردازنده، رم، دیسک، منبع تغذیه و سیستم خنک کننده را پوشش می دهد. در کنار تعمیر، ارتقای سخت افزار و نگهداری پیشگیرانه نیز بر اساس نیاز سازمان برای بهبود عملکرد و کاهش احتمال خرابی های بعدی انجام می شود.
- تشخیص خرابی
- بررسی قطعات
- تعمیر یا تعویض قطعه
- ارتقای سخت افزار
- تست عملکرد
- نگهداری پیشگیرانه
خدمات تعمیر و پشتیبانی سخت افزار شامل چیست؟
خدمات تعمیر و پشتیبانی سخت افزار از عیب یابی و رفع خرابی قطعات کامپیوتر و سرور تا ارتقا و نگهداری پیشگیرانه تجهیزات را شامل می شود. نوع بررسی و اقدام فنی بر اساس وضعیت دستگاه، اهمیت سرویس، سازگاری قطعات و نیاز مجموعه تعیین می شود.
تعمیر و پشتیبانی سرور
- بررسی Hardware Health
- CPU
- RAM
- RAID
- HDD / SSD
- Power Supply
- Fan
- Motherboard
- Controller
ارتقای سخت افزار
- RAM
- Storage
- CPU در صورت سازگاری
- RAID
- Network
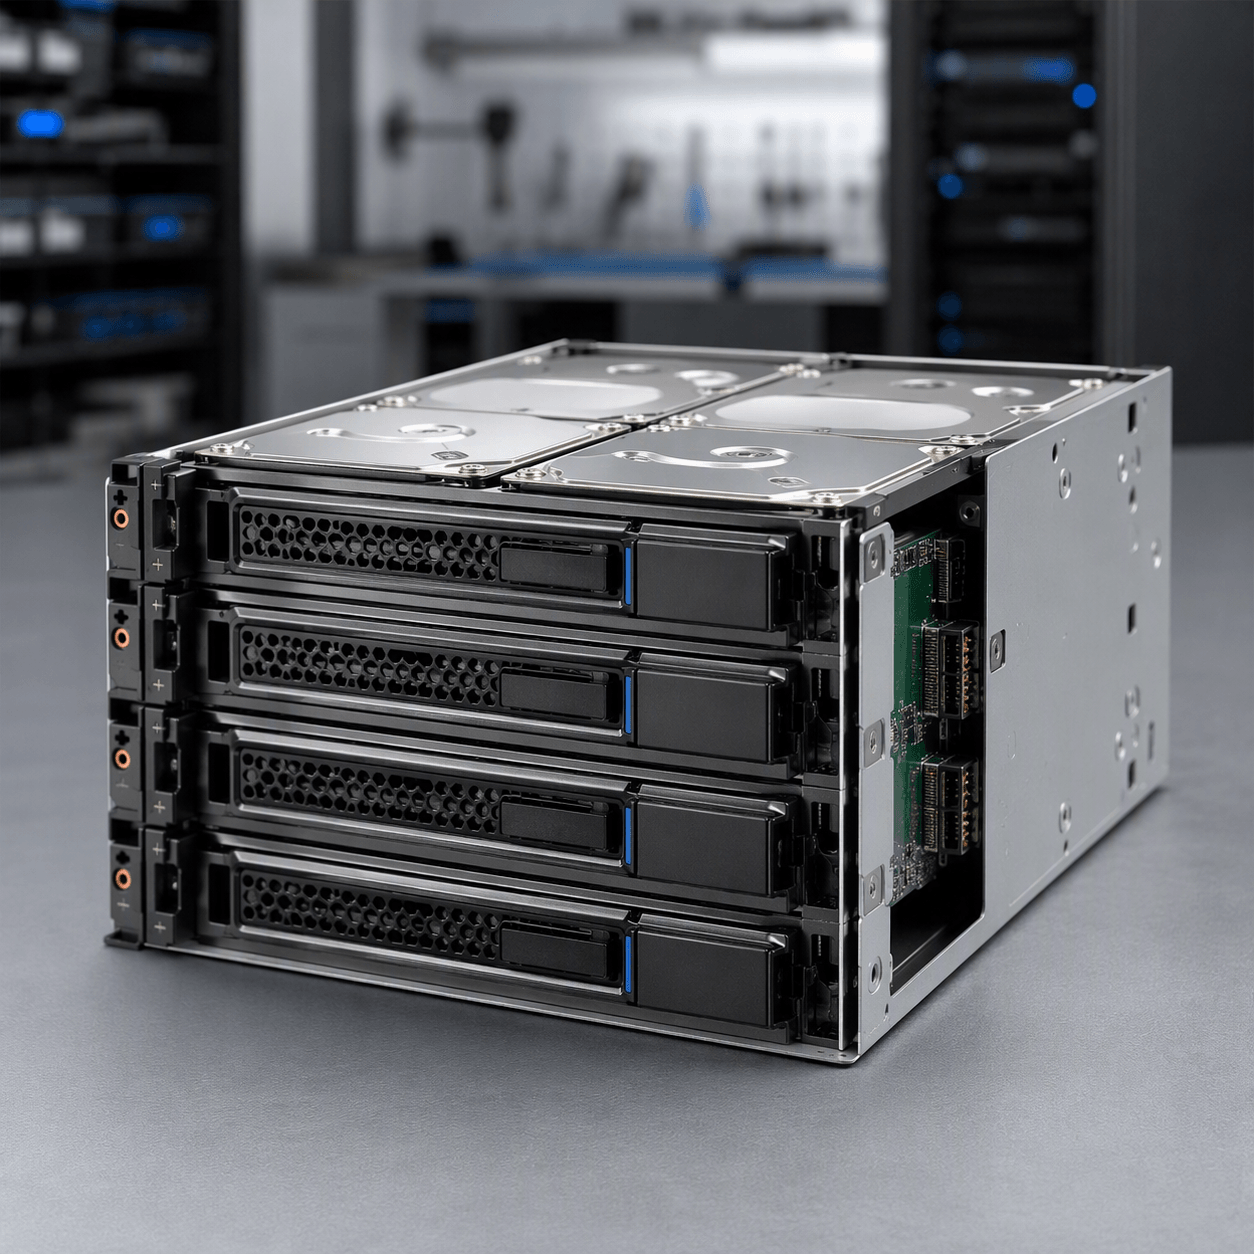
نگهداری پیشگیرانه
- بررسی وضعیت قطعات
- دما
- Fan
- Power
- Disk Health
- Firmware
- Log
تعمیر سخت افزار کامپیوتر
تعمیر سخت افزار کامپیوتر شامل شناسایی علت خرابی، بررسی امکان تعمیر، تعویض قطعات معیوب و آزمایش عملکرد دستگاه پس از رفع مشکل است. در محیط شرکت، هدف این خدمات بازگرداندن کامپیوتر به وضعیت قابل استفاده، حفظ اطلاعات و کاهش احتمال تکرار اختلال است. روشن شدن دستگاه به تنهایی نشانه پایان تعمیر نیست؛ سیستم باید در اجرای نرم افزارهای مورد نیاز کاربر، اتصال به شبکه و استفاده روزمره نیز عملکرد پایداری داشته باشد.
خدمات پشتیبانی سخت افزار کامپیوتر، علاوه بر رسیدگی به خرابی، وضعیت تجهیزات را در طول دوره استفاده بررسی می کند. این خدمات می تواند شامل سرویس دوره ای، ارتقای RAM و SSD، بررسی پاور و سیستم خنک کننده، تعمیر یا تعویض مادربرد و کارت شبکه باشد. انتخاب اقدام مناسب به عمر دستگاه، هزینه تعمیر، سازگاری قطعات و نقش کامپیوتر در فعالیت شرکت بستگی دارد.
عیب یابی کامپیوتر
عیب یابی کامپیوتر باید مرحله به مرحله و بر اساس شواهد انجام شود. تعویض قطعه بدون تشخیص علت خرابی ممکن است هزینه اضافی ایجاد کند و مشکل اصلی را باقی بگذارد. برای مثال، خاموش شدن ناگهانی دستگاه می تواند با خرابی پاور، افزایش دمای پردازنده، ایراد مادربرد یا مشکل برق ورودی ارتباط داشته باشد. بنابراین، مشاهده یک نشانه برای تعیین قطعه معیوب کافی نیست.
فرایند بررسی معمولا با ثبت توضیحات کاربر شروع می شود: مشکل از چه زمانی آغاز شده، در چه شرایطی رخ می دهد و آیا قبل از آن قطعه، نرم افزار یا تنظیماتی تغییر کرده است؟ سپس اتصالات، برق ورودی، وضعیت ظاهری قطعات و علائم زمان روشن شدن بررسی می شوند. در مراحل بعد، متناسب با نشانه ها، تست حافظه، بررسی سلامت ذخیره ساز، پایش دما و ارزیابی منبع تغذیه انجام می شود.
تفکیک ایراد سخت افزاری از مشکلات سیستم عامل، درایور و نرم افزار نیز ضروری است. کندی یا Restart همیشه به معنی خرابی قطعه نیست. استفاده از قطعه سالم و سازگار برای تست مقایسه ای می تواند به تشخیص کمک کند، اما خرید و تعویض نهایی باید بر مبنای نتیجه بررسی باشد.
پیش از اقداماتی که احتمال تغییر یا از دست رفتن اطلاعات دارند، وضعیت نسخه پشتیبان و اهمیت داده ها مشخص می شود. پس از تعمیر نیز دستگاه در شرایط مرتبط با خرابی اولیه آزمایش می شود و نتیجه، قطعات تعویض شده و توصیه های نگهداری ثبت می شوند.
مشکلات رایج سخت افزار کامپیوتر
نشانه های زیر از دلایل رایج درخواست تعمیر کامپیوتر در شرکت ها هستند. تشخیص نهایی هر مورد به بررسی دستگاه نیاز دارد.
| مشکل دستگاه | بررسی و اقدام فنی |
|---|---|
| روشن نشدن کامپیوتر | ابتدا پریز، کابل برق، کلید پاور و اتصالات بررسی می شوند. سپس منبع تغذیه و مادربرد ارزیابی می شوند. روشن شدن فن بدون نمایش تصویر با روشن نشدن کامل دستگاه متفاوت است و مسیر بررسی جداگانه ای دارد. |
| Restart ناگهانی | دمای پردازنده، عملکرد پاور، پایداری RAM و گزارش های سیستم بررسی می شوند. درایورها و خطاهای سیستم عامل نیز ممکن است عامل باشند؛ زمان وقوع Restart و ارتباط آن با اجرای برنامه های سنگین به تشخیص کمک می کند. |
| کندی ناشی از مشکل سخت افزاری | کمبود RAM، ذخیره ساز فرسوده یا معیوب و افت فرکانس پردازنده بر اثر گرما بررسی می شوند. ارتقا زمانی پیشنهاد می شود که محدودیت سخت افزاری مشخص شده باشد؛ هر کندی با نصب SSD یا افزایش RAM رفع نمی شود. |
| خطاهای RAM | هنگ، صفحه آبی و خطاهای اجرای برنامه ممکن است با حافظه ارتباط داشته باشند. تست ماژول ها، بررسی اسلات، سازگاری و تنظیمات حافظه انجام می شود. صفحه آبی به تنهایی اثبات کننده خرابی RAM نیست. |
| خرابی HDD / SSD | خطاهای خواندن، شناسایی نشدن درایو و وضعیت SMART بررسی می شوند. اگر نشانه های خرابی جدی وجود داشته باشد، اولویت با حفاظت از داده ها است. تست سنگین یا نوشتن اطلاعات روی درایو مشکوک ممکن است وضعیت را بدتر کند. |
| مشکل Power | خاموشی زیر بار، روشن شدن نامنظم یا ناپایداری می تواند به پاور مربوط باشد. ظرفیت، اتصالات و عملکرد آن بررسی می شوند. باز کردن پاور و تعمیر مدار داخلی باید توسط فرد متخصص انجام شود. |
| Overheating یا افزایش دما | گرد و غبار، خرابی فن، نصب نامناسب خنک کننده و گردش هوای ضعیف بررسی می شوند. پاکسازی اصولی، اصلاح تهویه و رسیدگی به اتصال حرارتی پردازنده می تواند لازم باشد؛ دما پس از سرویس دوباره ارزیابی می شود. |
| مشکل Motherboard | اختلال در راه اندازی، خرابی پورت ها یا شناسایی نشدن قطعات نیازمند بررسی مادربرد است. پیش از تصمیم به تعمیر برد یا تعویض آن، سلامت قطعات متصل و صرفه اقتصادی اقدام ارزیابی می شود. |
| مشکل کارت شبکه | قطعی ارتباط یا کاهش سرعت ابتدا با بررسی کابل، پورت سوئیچ، درایور و تنظیمات شبکه پیگیری می شود. در صورت تایید ایراد سخت افزاری، تعمیر یا جایگزینی کارت شبکه سازگار بررسی می شود. |
پشتیبانی سخت افزار کامپیوتر در شرکت
پشتیبانی سخت افزاری فقط تعمیر دستگاه خراب نیست؛ مجموعه ای از اقدامات برنامه ریزی شده برای حفظ قابلیت استفاده از تجهیزات، مدیریت هزینه و کاهش توقف کار کارکنان است. در شرکت، خرابی کامپیوتر حسابداری یا سیستم مورد استفاده انبار ممکن است چند فرایند را هم زمان مختل کند. به همین دلیل، اولویت رسیدگی باید بر اساس اثر خرابی بر کار سازمان تعیین شود.
ثبت تجهیزات
نخست، فهرست کامپیوترها و مشخصات آنها تهیه می شود. مدل دستگاه، شماره سریال، پردازنده، ظرفیت RAM، نوع ذخیره ساز، محل استقرار و کاربر مسئول ثبت می شوند. این اطلاعات امکان شناسایی دستگاه های قدیمی، بررسی سازگاری قطعات و برنامه ریزی خرید را فراهم می کند.
بررسی سلامت
وضعیت ذخیره ساز، دما، فن ها، خطاهای حافظه و نشانه های ناپایداری به تناسب اهمیت تجهیزات بررسی می شوند. نتایج باید قابل پیگیری باشند تا تغییر وضعیت دستگاه مشخص شود. پایش سلامت به شناسایی بعضی مشکلات کمک می کند، اما جایگزین نسخه پشتیبان نیست و همه خرابی ها را پیش بینی نمی کند.
نگهداری تجهیزات
پاکسازی اصولی گرد و غبار، بررسی اتصالات، کنترل تهویه و رسیدگی به فن ها بخشی از نگهداری هستند. فاصله سرویس ها به شرایط محیط و میزان استفاده بستگی دارد. کامپیوتر مستقر در محیط پرگردوغبار کارخانه ممکن است نسبت به دستگاه اداری به بازدید بیشتری نیاز داشته باشد.
ارتقای سخت افزار
پیشنهاد ارتقا باید بر اساس نیاز شغلی و محدودیت واقعی دستگاه ارائه شود. افزایش RAM، جایگزینی HDD با SSD یا ارتقای کارت شبکه پس از بررسی سازگاری و هزینه انجام می شود. گاهی فرسودگی مجموعه قطعات باعث می شود جایگزینی کامل دستگاه تصمیم منطقی تری باشد.
تعویض قطعه
قطعه جایگزین باید از نظر مشخصات فنی، ابعاد، توان مصرفی و رابط اتصال با دستگاه سازگار باشد. برای ذخیره سازها، انتقال اطلاعات و تعیین تکلیف قطعه قبلی نیز اهمیت دارد. پس از نصب، عملکرد سیستم آزمایش و مشخصات قطعه جدید ثبت می شود.
مستندسازی خدمات
شرح خرابی، علت شناسایی شده، اقدامات انجام شده و نتیجه آزمایش در سابقه دستگاه ثبت می شوند. این سوابق به تشخیص خرابی های تکراری و تصمیم گیری درباره ادامه تعمیر یا نوسازی کمک می کنند.
برنامه نگهداری و هماهنگی پشتیبانی
زمان بازدید، مسئول پیگیری، اولویت تجهیزات و روش ثبت درخواست مشخص می شود. بررسی اولیه بعضی خطاها از راه دور امکان پذیر است؛ تعمیر فیزیکی نیازمند حضور یا انتقال دستگاه است. در قرارداد پشتیبانی نیز دامنه خدمات، هزینه قطعات و شرایط رسیدگی باید روشن باشد.
هنگام تماس، تعداد دستگاه ها، محل شرکت، نشانه خرابی و تاثیر آن بر فعالیت کاربران را اعلام کنید.
اختلال سخت افزاری، کار کاربران شرکت را متوقف کرده است؟
برای عیب یابی کامپیوتر، بررسی خرابی قطعات، ارتقای سخت افزار یا هماهنگی پشتیبانی تجهیزات شرکت تماس بگیرید. هنگام تماس، تعداد دستگاه ها، نشانه خرابی، زمان شروع مشکل و تاثیر آن بر فعالیت کاربران را اعلام کنید.
تماس بگیرید عیب یابی و پشتیبانی سخت افزار
تعمیر سخت افزار سرور
تعمیر سخت افزار سرور یکی از بخشهای مهم پشتیبانی زیرساخت فناوری اطلاعات است؛ زیرا سرور معمولا میزبان سرویسهایی مانند فایلهای سازمانی، نرمافزارهای مالی، اتوماسیون، پایگاه داده، ماشینهای مجازی و سرویسهای شبکه است. هرگونه اختلال در قطعات سرور میتواند روی دسترسی کاربران، عملکرد نرمافزارها یا پایداری سرویسها اثر بگذارد.
با این حال، مشاهده یک هشدار، کند شدن سیستم یا Restart شدن سرور بهتنهایی برای تعیین علت خرابی کافی نیست. یک نشانه ممکن است به قطعه سخت افزاری، تنظیمات Firmware، وضعیت RAID، سیستمعامل، منبع تغذیه، دمای محیط یا حتی فشار کاری مربوط باشد. به همین دلیل، عیبیابی باید مرحلهبهمرحله و با توجه به مدل سرور، سابقه خطاها و اهمیت سرویسهای در حال اجرا انجام شود.
در فرآیند تعمیر سرور، ابتدا وضعیت فعلی تجهیزات ثبت میشود. مدل سرور، نسل دستگاه، سیستمعامل یا Hypervisor، نوع ذخیرهسازی، ساختار RAID، وضعیت Redundant Power و پیامهای ثبتشده در ابزارهای مدیریتی باید در نظر گرفته شوند. در سرورهای HPE، بررسی گزارشهای مدیریتی مانند iLO و وضعیت کنترلرهای ذخیرهسازی میتواند بخشی از فرآیند تشخیص باشد. البته تصمیم نهایی برای تعمیر، تعویض یا ارتقا تنها پس از بررسی فنی و ارزیابی ریسک انجام میشود.
چه قطعاتی در سرور بررسی می شوند؟
بررسی سخت افزار سرور فقط به هارد یا پاور محدود نیست. بسیاری از قطعات بهصورت مستقیم یا غیرمستقیم بر پایداری سرور اثر میگذارند. در زمان عیبیابی، وضعیت قطعات زیر با توجه به معماری سرور و علائم مشاهدهشده بررسی میشود:
- CPU؛ پردازنده و وضعیت بار کاری
- RAM؛ ماژولهای حافظه و خطاهای Memory
- HDD؛ دیسکهای مکانیکی و وضعیت سلامت آنها
- SSD؛ درایوهای جامد و خطاهای خواندن و نوشتن
- RAID Controller؛ کنترلر و وضعیت آرایه ذخیرهسازی
- Power Supply؛ پاور و وضعیت تغذیه سرور
- Fan؛ فنها و عملکرد سیستم خنککننده
- Motherboard؛ برد اصلی، اسلاتها و اتصالات
- Network Interface؛ رابطها و کارتهای شبکه
- Storage Controller؛ کنترلرها و مسیر ارتباط با دیسکها
در بخش پردازنده، مصرف CPU، پیامهای خطا و رفتار سیستم هنگام بار کاری بررسی میشود؛ اما افزایش مصرف CPU لزوما به معنی خرابی پردازنده نیست. در بخش RAM، خطاهای ثبتشده، سازگاری ماژولها، اسلاتها و نشانههای Memory Error اهمیت دارند. درباره HDD و SSD نیز وضعیت سلامت درایو، خطاهای خواندن و نوشتن، زمان پاسخگویی و سابقه خطا باید در کنار وضعیت RAID بررسی شود.
کنترلر RAID و Storage Controller نقش مهمی در ارتباط سرور با دیسکها دارند. بنابراین مشاهده خطای Disk یا Degraded شدن RAID نباید بهصورت خودکار به خرابی یک دیسک نسبت داده شود. لازم است وضعیت آرایه، کابلها، Backplane، کنترلر، Firmware و گزارشهای مدیریتی بررسی شود. اجرای Rebuild بدون بررسی شرایط آرایه و وضعیت دیسکها نیز میتواند ریسک بیشتری ایجاد کند؛ به همین دلیل قبل از هر اقدام، وضعیت دادهها و نسخههای پشتیبان باید ارزیابی شود.
پاور، فن و مادربرد نیز در پایداری سرور مؤثرند. خرابی پاور، نوسان برق، اتصال نامناسب یا مشکل در مسیر تغذیه ممکن است با خاموشی یا Restart همراه شود، اما برای تشخیص قطعی باید تست فنی انجام شود. افزایش دما نیز ممکن است از گرفتگی مسیر هوا، خرابی Fan، دمای نامناسب رک، گردوغبار یا بار کاری بالا ناشی شود. بنابراین تعویض فوری قطعه بدون علتیابی همیشه راهکار مناسبی نیست.
علائم خرابی سخت افزار سرور
علائم زیر میتوانند نشانه وجود مشکل در سخت افزار یا یکی از اجزای مرتبط با سرور باشند. این موارد برای شروع بررسی اهمیت دارند، اما هیچکدام بهتنهایی علت قطعی خرابی را مشخص نمیکنند:
در صورت مشاهده این علائم، بهتر است از خاموش و روشن کردن مکرر سرور یا اجرای عملیات پرریسک روی RAID بدون بررسی خودداری شود. ابتدا باید مشخص شود کدام سرویسها روی سرور فعال هستند، آیا نسخه پشتیبان قابل استفاده وجود دارد و آیا امکان بررسی در زمان کمخطر یا پنجره نگهداری فراهم است. در برخی موارد، تهیه گزارش از وضعیت فعلی، Logها و چراغهای هشدار پیش از تغییر قطعه، به تشخیص دقیقتر کمک میکند.
خدمات تعمیر سخت افزار سرور میتواند شامل بررسی قطعات، عیبیابی خطاهای ذخیرهسازی، ارزیابی RAID، تست پاور و فن، بررسی RAM و CPU، تحلیل وضعیت Network Interface و پیشنهاد تعمیر یا تعویض قطعه باشد. اگر سرور از برند HPE باشد، بررسی مستندات رسمی و راهنمای مدل دستگاه نیز برای رعایت ترتیب صحیح بازکردن، نصب قطعه و انجام تستهای پس از تعمیر اهمیت دارد.
پس از تعمیر یا تعویض قطعه، تست عملکرد باید متناسب با نقش سرور انجام شود. این تست ممکن است شامل بررسی سلامت دیسکها، وضعیت RAID، دمای قطعات، منابع CPU و RAM، وضعیت شبکه، ثبت نشدن خطای جدید و صحت عملکرد سرویسهای اصلی باشد. در سرورهای سازمانی، بهتر است نتیجه بررسی، قطعه تعویضشده، خطاهای مشاهدهشده و پیشنهادهای نگهداری نیز مستندسازی شود.
برای آشنایی با خدمات مکمل نگهداری، پایش و عیبیابی میتوانید صفحه خدمات پشتیبانی سرور را ببینید. همچنین جزئیات مرتبط با تعمیر سرور HP و HPE نیز در صفحه تخصصی این خدمت توضیح داده شده است.
برای دستورالعملهای رسمی مربوط به سرویس و نگهداری سرورهای HPE، مراجعه به مستندات رسمی HPE توصیه میشود. هنگام تماس برای بررسی، ارائه مدل دقیق سرور، کد خطا، زمان شروع مشکل، وضعیت RAID و تاثیر اختلال بر سرویسهای سازمان میتواند به هماهنگی بهتر فرآیند عیبیابی کمک کند.
تعمیر سرور HP
سرورهای شرکت اچ پی ستون اصلی زیرساخت پردازشی، دیتاسنترها و ذخیره سازی اطلاعات در شرکت ها و سازمان های مدرن به شمار می روند. از نسل های اولیه تا نسل های جدید نظیر سرور HP ProLiant Gen9 و Gen10 و Gen11، پایداری بی وقفه این ماشین ها تضمین کننده در دسترس بودن پایگاه های داده، سیستم های حسابداری و اتوماسیون، ماشین های مجازی و وب سرویس های حیاتی است. کوچکترین اختلال فنی در بخش تامین توان، آرایه های دیسک یا بردهای الکترونیکی می تواند ساعت ها توقف کاری پرهزینه به همراه داشته باشد. ما خدمات تعمیر سرور HP را به عنوان یک فرایند قطعی و پشتیبانی بدون ریسک ارائه می دهیم تا مدیران شبکه و مالکان کسب و کار با اطمینان کامل از پایداری داده های سازمانی خود محافظت نمایند.
تعمیر و عیب یابی سرور HP
تعمیرات موفق سرور قبل از تعویض قطعه با عیب یابی ریشه ای آغاز می شود. استفاده از ابزارهای تخصصی کمپانی اچ پی، بررسی گزارش های لاگ پردازنده مدیریتی مجزا موسوم به iLO و تست های تشخیصی تحت بوت سخت افزار به کارشناسان ما امکان می دهد منشا دقیق خطا را تفکیک کرده و بدون آسیب به پیکربندی های نرم افزاری یا سیستم عامل اقدام به رفع نقص نمایند:


چه مشکلاتی در سرور HP قابل بررسی است؟
معماری ماژولار سرورهای اچ پی به گونه ای است که بروز اختلال در هر قطعه با علائم رفتاری معین و کدهای مشخص در کنسول مدیریت نمایان می شود. تکنسین های باسابقه با آگاهی از رفتار پلتفرم قطعات زیر را تحت آزمایش جامع قرار می دهند:
| قطعه | مشکل قابل بررسی |
|---|---|
| HDD / SSD | خطای دیسک، افت سلامت، افزایش بدسکتور، تاخیر پاسخگویی و چشمک زدن کهربایی LED درایو |
| RAID | Degraded / Failed Array، پریدن کانفیگ کش و غیرفعال شدن عملیات نوشتن سریع به دلیل خرابی باتری |
| RAM | Memory Error، غیرفعال شدن اسلات کانال پردازنده و ریستارت های ناگهانی با خطای صفحه آبی یا پرپل اسکرین |
| Power | Power Failure، قطع ویژگی همپوشانی و ریداندنسی پاور و خاموشی های ناشی از بار مصرفی بالای پردازنده ها |
| Fan | خطای خنک کننده، بالا رفتن دور موتور در حالت بیکاری، خرابی سنسور حرارتی و خاموشی خودکار برای حفاظت حرارتی |
| Controller | خطای مدیریت Storage، عدم شناسایی دیسک های متصل به بک پلن و کرش کردن کنترلرهای سری اسمارت اری |
| Network | اختلال رابط شبکه، افت پکت، قطع ارتباط پورت های اترنت ۱۰ گیگابیت یا فیبر نوری و خطای فریمور کارت شبکه |
تحلیل تخصصی قطعات کلیدی در تعمیرات سرور اچ پی
سرورهای رکمونت مدل های پرطرفداری همچون ProLiant DL380 و DL360 و سرورهای ایستاده مانند ML350 دارای معماری فشرده و حساسی هستند. شناخت رفتار فنی هر بخش پایه اصلی تعمیرات موفق و پایدار است:
۱. تعمیر و تعویض حافظه های رم و پیکربندی چند کاناله
حافظه های سرور از نوع رجیستر شده و برخوردار از فناوری ECC هستند که می توانند خطاهای تک بیتی داده را اصلاح کنند. با این حال زمانی که ماژول حافظه دچار فرسایش شدید می شود، خطاهای چند بیتی اصلاح ناپذیر رخ می دهند. این خطاها توسط بایوس سرور ثبت و به اصطلاح اسلات مربوطه در حالت ایزوله قرار می گیرد تا از کرش سیستم جلوگیری شود. در خدمات تعمیر سرور HP چینش رم ها بر اساس دستورالعمل ترتیبی سوکت های پردازنده تست شده و ماژول های ناسازگار با نمونه های اورجینال جایگزین می گردند.
۲. احیای سیستم های ذخیره سازی، رید کنترلر و باتری کش Smart Array
کنترلرهای رید در سرورهای اچ پی وظیفه مدیریت نوشتن و خواندن اطلاعات روی دیسک های اس اس دی و هارد دیسک های ساس را بر عهده دارند. این کنترلرها مجهز به حافظه فلش با پشتوانه خازن هوشمند به جای باتری های سنتی هستند. در صورت خرابی خازن یا بروز خطا در ارتباط با بک پلن دیسک، سرعت نوشتن به شدت افت پیدا می کند زیرا حالت شتاب دهنده حافظه کش موقتا مسدود می شود. کارشناسان ما قادرند بدون خطر از دست رفتن داده های پارتیشن ها یا آسیب به دیتابیس های حجیم، اقدام به بازسازی آرایه های تخریب شده و تعویض ماژول های ذخیره ساز نمایند.
۳. پردازنده مدیریتی iLO و بازخوانی گزارش های امنیتی
تراشه مستقل iLO در دل مادربرد سرور قرار دارد و حتی در زمانی که سرور خاموش است کار می کند. از طریق دسترسی راه دور به این پردازنده می توان وضعیت ولتاژ خطوط برق، دور فن ها، دمای هر هسته پردازنده زئون و گزارش ثبت وقایع سخت افزاری را بدون نیاز به ورود به سیستم عامل مانیتور کرد. بسیاری از اشکالات پیچیده مانند خطاهای زمان بندی رم یا افت سرعت باس با خواندن دقیق این گزارش ها در کوتاه ترین زمان شناسایی می شوند.
مراحل پیاده سازی پشتیبانی قطعی سرور در محل و آزمایشگاه
ما یک چرخه کاملا استاندارد و شفاف را برای بازگرداندن سرورهای سازمانی به شرایط پایدار دنبال می کنیم:
پشتیبانی قطعی و تضمین شده سرورهای سازمانی HP
عیب یابی فوری سخت افزاری، تامین قطعات اورجینال سرورهای رکمونت و تاور و بازگردانی فوری سرویس های شبکه بدون اختلال کاری
تعمیر سرور در محل
نگهداری و رفع خرابی سرورهای سازمانی نیازمند تصمیم گیری دقیق میان دو گزینه اساسی است: عیب یابی در اتاق سرور مشتری یا انتقال دستگاه به آزمایشگاه تخصصی. ما با رویکردی مهندسی و دور از ادعاهای غیرواقعی اعلام می کنیم که همه تعمیرات در محل کارفرما ممکن نیستند. هدف ما به حداقل رساندن توقف کاری، حفظ یکپارچگی داده ها و جلوگیری از ریسک های فیزیکی است. در مواردی که نقص فنی با بررسی محیطی و تعویض ماژول های هات پلاگ رفع می شود حضور در محل بهترین گزینه است؛ اما در آسیب های عمیق الکترونیکی و تست های چندروزه انتقال شاسی به کارگاه مجهز ایمن ترین مسیر خواهد بود.
چه زمانی تعمیر در محل مناسب است؟
تعمیر و عیب یابی در محل مشتری برای مواردی اولویت دارد که خطای سرور به طور مستقیم با اتصالات فیزیکی، شبکه سازمانی یا قطعات ماژولار قابل تعویض در ارتباط است. در این شرایط جابجایی سرور نه تنها زمان بر است بلکه ریسک خطاهای جدید را افزایش می دهد:
چه زمانی انتقال تجهیزات منطقی تر است؟
برخی خرابی ها به دلیل ساختار میکروسکوپی و پیچیدگی الکترونیکی امکان رفع در محل کارفرما را ندارند. تلاش برای انجام این امور درون اتاق سرور مشتری علاوه بر آلودگی محیطی می تواند به خرابی غیرقابل بازگشت بردها منجر شود:
جدول راهنمای انتخاب شیوه تعمیر سرور
جدول زیر به شما کمک می کند تا با توجه به نوع علامت و وضعیت عملکردی سرور سازمان خود، سریع ترین و ایمن ترین شیوه اقدام فنی را پیش بینی کنید:
| نوع قطعه و اختلال | شرح عملیات مورد نیاز | روش اجرایی استاندارد | مدت زمان تقریبی |
|---|---|---|---|
| هارد دیسک و SSD | تعویض درایو معیوب و بررسی سلامت ریبیلد رید (RAID Rebuild) | تعمیر در محل | ۱ الی ۳ ساعت |
| منبع تغذیه (Power Supply) | تست هات پلاگ و جایگزینی ماژول پاور سازگار با توان مشابه | تعمیر در محل | کمتر از ۱ ساعت |
| ماژول حافظه RAM | تست اسلات های پردازنده، رفع کد خطای رم و جایگزینی ماژول ECC | تعمیر در محل | ۱ الی ۲ ساعت |
| مادربرد و مدار VRM | تعمیر اتصالات کوتاه برد، ریبال چیپست ها و تعویض ترانزیستورها | انتقال به کارگاه | ۲۴ الی ۷۲ ساعت |
| کنترلر رید (Smart Array) | تعویض باتری و خازن کش روی ریل یا تعمیر برد کنترلر در صورت خرابی چیپ | در محل / کارگاه | بسته به عمق خطا |
| فن و هیت سینک حرارتی | گردگیری سیستم جریان هوا و تعویض ماژول های پرسرعت فن سرور | تعمیر در محل | ۱ الی ۲ ساعت |
| پروگرم فیزیکی آی سی iLO | جدا کردن چیپ از روی برد و پروگرام مستقیم با سورس کد کارخانه | انتقال به کارگاه | ۲۴ الی ۴۸ ساعت |
رویکرد شفاف و تعهد امنیت داده در تعمیرات سازمانی
پیش از تصمیم برای حمل هرگونه تجهیزات، کارشناسان ما ابتدا از طریق ابزارهای مانیتورینگ از راه دور یا حضور سریع اولیه، تحلیل سخت افزاری را انجام می دهند. در صورتی که نیاز به جابجایی سرور باشد، طبق پروتکل استاندارد امنیتی، هارد دیسک های حاوی اطلاعات حساس تجاری در محل مشتری تحویل نماینده قانونی سازمان می گردد و شاسی سرور بدون ریسک افشای اطلاعات جهت تعمیرات الکترونیکی منتقل می شود. پس از اتمام تعمیرات در کارگاه، تست های کارکردی تحت لود کامل انجام شده و دستگاه با سلامت کامل مجددا درون رک نصب و تنظیم خواهد شد.
نیاز به اعزام فوری کارشناس سرور به محل سازمان دارید؟
درخواست خود را ثبت نمایید تا پس از ارزیابی اولیه خطای دستگاه، مناسب ترین سناریوی عیب یابی در محل یا آزمایشگاهی اجرا گردد.
تعمیر یا تعویض قطعه؛ کدام انتخاب مناسب است؟
هنگام مواجهه با نقص فنی در سرورها و تجهیزات پردازشی، پاسخ تک کلمه ای به دوراهی «تعمیر یا تعویض» وجود ندارد. اتخاذ یک تصمیم قطعی و یک طرفه معمولا به اتلاف منابع مالی یا تحمیل ریسک توقف های ناگهانی منجر می شود. یک تصمیم فنی استاندارد برآیندی چندوجهی از ارزیابی خطرات، پایداری سرویس و توجیه اقتصادی است. هیچ فرمول ثابتی نمی تواند جایگزین سنجش شرایط محیطی و فنی شود؛ زیرا قطعه ای که در یک سیستم تست قابل احیا و تعمیر است، در یک پایگاه داده سازمانی با حساسیت ۲۴ ساعته باید بلافاصله تعویض گردد.
معیارهای نه گانه در تعیین مسیر تعمیر یا جایگزینی
پیش از نهایی کردن سفارش خرید قطعه نو یا ارسال برد به کارگاه، مهندس نگهداری باید نه شاخص اصلی زیر را به شکل متوازن ارزیابی کند:
ماهیت فیزیکی یا منطقی نقص نقشی تعیین کننده دارد. مشکلات مربوط به خازن های دشارژ شده یا قطعی مسیرهای ولتاژ پایین اغلب قابل رفع هستند؛ اما سوختگی عمیق برد چندلایه، تاب برداشتن سوکت پردازنده یا خرابی هد مکانیکی هارد امکان احیای پایدار را به شدت کاهش می دهد.
تعمیر ماژول های ارزان قیمت مانند فن های متداول یا کابل های انتقال دیتا معمولا به صرفه نیست و زمان صرف شده ارزش فنی ندارد. برعکس، بردهای مادربرد نسل بالا، استوریج کنترلرهای پیشرفته و پردازنده های پرهزینه دلایل موجه تری برای سنجش گزینه تعمیر ایجاد می کنند.
قطعه ای که سال ها زیر فشار بار کاری سنگین و دمای بالا فعالیت کرده دچار استهلاک حرارتی می شود. تعمیر یک بخش کوچک در چنین تجهیزی مانع از خرابی بخش های فرسوده مجاور آن در بازه زمانی کوتاه نخواهد شد و به اصطلاح زنجیره خرابی ادامه پیدا می کند.
وجود قطعه یدکی اصل در بازار داخلی یا انبار آماده عامل زمان را تعیین می کند. اگر تهیه نسخه جایگزین نیاز به سفارش گذاری خارجی و هفته ها انتظار داشته باشد، بررسی روش تعمیر موقت یا دائم تا زمان تامین قطعه جدید به عنوان یک الزام مطرح می شود.
میزان اطمینان پس از تعمیر بر اساس پیچیدگی قطعه سنجیده می شود. قطعات الکترومکانیکی یا تراشه های حرارتی بعد از ترمیم، ریسک بالاتری برای تکرار ارور دارند. در مقابل، تعویض یک ماژول با نسخه اصلی و تست شده احتمال توقف های تکراری را به حداقل می رساند.
محاسبه کارمزد کارشناسی دقیق، ابزارهای مصرفی و دستمزد زمان دیباگ باید شفاف باشد. اگر هزینه تعمیرات الکترونیکی بیش از بخش عمده ای از ارزش یک ماژول سالم باشد، صرف این هزینه به همراه پذیرش ریسک های ذاتی تعمیرات غیرمنطقی خواهد بود.
تنها قیمت خرید قطعه نو ملاک نیست؛ هزینه های جانبی مانند لایسنس های مرتبط با سخت افزار جدید، زمان مورد نیاز برای کانفیگ و تطبیق با قطعات قدیمی نیز باید در مجموع هزینه تعویض لحاظ گردند. گاهی هزینه سازگاری از خود قطعه بالاتر است.
میزان حساسیت بار کاری و نقش سرور در کسب و کار مشخص می کند چه سطحی از ریسک قابل قبول است. روی سرورهای پایگاه داده مالی و سامانه های سازمانی حیاتی، کمترین احتمال توقف پذیرفته نیست؛ در حالی که روی سرورهای تست می توان ریسک آزمون تعمیر را پذیرفت.
اعتبار ضمانت شرکتی سرور یا قطعه، دستکاری سخت افزاری را محدود می کند. باز کردن دستگاه و اقدام به لحیم کاری می تواند گارانتی کلی سیستم یا شاسی را باطل کند. همچنین وجود ضمانت روی قطعه تعویضی جدید، آسودگی خاطر بیشتری برای مدیران ایجاد می کند.
ماتریس ارزیابی واقع بینانه بر اساس سناریوهای رایج
بررسی متقاطع این فاکتورها نشان می دهد چرا تعیین تکلیف سخت افزار نیازمند بررسی مورد به مورد است و راهکار ثابتی برای همه سازمان ها صدق نمی کند:
| قطعه و نوع خرابی نمونه | سطح اهمیت سرویس | وضعیت دسترسی در بازار | مسیر پیشنهادی بررسی | ملاحظات تصمیم گیری |
|---|---|---|---|---|
| هارد دیسک با بدسکتور | بالا (بانک اطلاعاتی) | موجود در انبار | اولویت قطعی تعویض | ریسک از دست رفتن دیتا هیچ گونه تعمیر موقت را توجیه نمی کند. |
| مادربرد با خرابی خازن مدار تغذیه | متوسط (فایل سرور داخلی) | زمان بر و نیازمند واردات | اولویت با بررسی تعمیر | تعمیر الکترونیکی مسیر سریعتری برای بازگرداندن سیستم فراهم می کند. |
| منبع تغذیه دارای افت ولتاژ شدید | بالا (سرور اتوماسیون اداری) | موجود در بازار | اولویت با تعویض | ریسک سوختن سایر قطعات در صورت تعمیر ناقص پاور بسیار بالاست. |
| کنترلر رید با خطای حافظه کش | بسیار بالا (Core Infrastructure) | محدود | نیازمند تست مرحله ای | بررسی باتری و کش ماژول در محل؛ در صورت خرابی چیپ اصلی، تعویض کامل کنترلر. |
| فن سرور با صدای غیرعادی | پایین تا متوسط | به راحتی در دسترس | اولویت قطعی تعویض | قطعه ای کم هزینه که تعمیر آن فاقد توجیه اقتصادی و زمانی است. |
رویکرد تحلیلی و عدم وجود نسخه ثابت
با کنار هم قرار دادن شاخص های فوق مشخص می شود که هیچ یک از دو راهکار تعمیر یا تعویض نمی توانند به عنوان انتخاب برتر همیشگی معرفی شوند. مدیران فناوری اطلاعات باید با لحاظ کردن توجیه اقتصادی، زمان مجاز توقف سرویس و موجودی بازار آزاد، رویکرد منعطفی در پیش بگیرند. گاهی مناسب ترین تصمیم مهندسی، تعمیر موقت برای بازیابی سریع سرویس و همزمان ثبت سفارش خرید قطعه جایگزین جهت نصب در پنجره های نگهداری آتی است. هدف نهایی، دستیابی به بالاترین میزان پایداری با متعادل ترین هزینه عملیاتی خواهد بود.
ارتقای سخت افزار سرور و کامپیوتر
رشد مداوم حجم پایگاه داده ها، افزایش تعداد کاربران همزمان و پیاده سازی سرویس های مجازی سازی سنگین باعث می شود توان سخت افزاری اولیه سرورها و سیستم های اداری پس از مدتی پاسخگوی بار کاری نباشد. ارتقای هدفمند سخت افزار یک راهکار منطقی برای بازگرداندن چابکی به زیرساخت فناوری اطلاعات بدون تحمیل هزینه سنگین خرید شاسی و سرور جدید است. با این حال اجرای این فرایند نیازمند مهندسی دقیق و شناخت عمیق معماری سخت افزار است تا سیستم دچار گلوگاه پردازشی یا ناسازگاری های بحرانی نشود.
پیش نیاز حیاتی: بررسی جامع سازگاری (Compatibility Check)
خرید بدون ارزیابی فنی و اتصال مستقیم قطعات جدید به سرور و کامپیوتر می تواند موجب خطاهای ناشناخته، عدم بوت سیستم یا آسیب فیزیکی به بردها شود. پیش از هرگونه ارتقا، پنج لایه سازگاری زیر به دقت بررسی و تطبیق داده می شوند:
بررسی فرم فکتور شاسی، پارت نامبر مادربرد، تعداد اسلات های PCIe آزاد، نسل ارتباطی و حداکثر پهنای باند الکتریکی قابل تامین.
پشتیبانی کارت رید یا HBA از سرعت های 6G و 12G، پروتکل های SAS و SATA و توانایی آدرس دهی به درایوهای با ظرفیت بالا.
به روزرسانی نسخه BIOS، چیپ iLO/iDRAC و فریمور کنترلر ذخیره ساز برای رفع تداخل های شناسایی سخت افزار نسل جدید.
محاسبه سقف ظرفیت رم قابل پذیرش توسط پردازنده، استانداردهای RDIMM یا LRDIMM و همچنین محدودیت های کش در آرایه های دیسک.
مولفه های قابل ارتقا در سرورها و رایانه های سازمانی
پس از پایان موفقیت آمیز بررسی سازگاری، متناسب با گلوگاه اصلی سیستم ارتقای بخش های سخت افزاری زیر به شکل مستقل یا ترکیبی اجرا می شود:
رفع کندی ناشی از کمبود حافظه در ماشین های مجازی (VMware ESXi یا Proxmox) و پایگاه داده های SQL. افزودن ماژول های حافظه با تکنولوژی تصحیح خطا (ECC) و تطبیق دقیق فرکانس و تایمینگ کانال های چندگانه حافظه به منظور حفظ بالاترین سطح پایداری بدون کرش های ناگهانی.
افزودن درایوهای ذخیره ساز Enterprise SAS یا NVMe SSD جهت ارتقای چشمگیر نرخ ورودی و خروجی داده (IOPS). این تغییر زمان خواندن و نوشتن سرویس های پرترافیک مانند نرم افزارهای مالی و اتوماسیون سازمانی را به حداقل رسانده و تاخیر انتقال اطلاعات را از بین می برد.
افزایش فضای ذخیره سازی فله ای برای اهداف ذخیره لاگ ها، فایل های حجیم سازمانی و مخازن نسخه های پشتیبان (Backup Repository). استفاده از هارد دیسک های انترپرایز با استاندارد کارکرد پیوسته و سرعت گردش ۷۲۰۰ دور در دقیقه با پورت های اینترفیس SAS و SATA.
مهاجرت از سطوح ساده دیسک به ریدآرایه های پیشرفته تر نظیر RAID 10 یا RAID 6 به منظور افزایش همزمان سرعت و پایداری در برابر سوختن همزمان دو دیسک. همچنین افزودن حافظه کش با باتری پشتیبان (FBWC / BBWC) روی کارت کنترلر جهت فعال سازی ویژگی نوشتن تاخیری (Write-Back).
جایگزینی پورت های سنتی گیگابیتی با کارت های شبکه پرسرعت ۱۰ گیگابیت (10GbE SFP+ یا Base-T) و فیبر نوری، به همراه پیکربندی ویژگی های پیشرفته مانند NIC Teaming و VLAN Tagging. این کار گلوگاه های انتقال ترافیک بین هاست ها، فضای ذخیره سازی شبکه ای SAN و کاربران را حذف می کند.
نصب پردازنده دوم در سرورهای دو سوکته یا تعویض CPU فعلی با مدل های دارای هسته های بیشتر و فرکانس بالاتر، منوط به پشتیبانی برد و سیستم خنک کننده. این ارتقا توانایی پاسخگویی به درخواست های پردازشی سنگین، فشرده سازی ها و محاسبات همزمان را به صورت تصاعدی بالا می برد.
افزودن قطعات قدرتمندتر به معنای کشش جریان بیشتر از پاور سرور است. ارتقای ماژول های منبع تغذیه به وات های بالاتر (مثلا از ۵۰۰ وات به ۸۰۰ یا ۱۴۰۰ وات) و فعال سازی حالت ریداندنت (Redundant Power) باعث می شود برق رسانی پایدار تضمین شده و در صورت نوسان یا از کار افتادن یک منبع، سرور بدون خاموشی به کار خود ادامه دهد.
تعویض هارد و Storage سرور
تجهیزات ذخیره سازی ستون فقرات داده های سازمان هستند و فرایند خارج کردن یا جایگزینی درایوها با ریسک ذاتی از دست رفتن اطلاعات همراه است. هرگونه مداخله بدون اشراف کامل بر ساختار ذخیره ساز، سطح افزونگی آرایه ها و نوع کنترلر می تواند منجر به تخریب همیشگی پارتیشن ها یا خطای توقف سیستم شود. در این سطح از نگهداری زیرساخت، رویکردهای هیجانی یا نسخه های بدون سنجش معماری جایی ندارند و حفظ سلامت داده ها اولویت مطلق به شمار می رود.
پیش نیاز غیرقابل چشم پوشی: بررسی وضعیت RAID و نسخه پشتیبان (Backup)
پیش از لمس فیزیکی هر درایو یا باز کردن قفل کیج، راستی آزمایی دو شاخص حیاتی زیر اجباری است. هرگز نباید پیش از اطمینان کامل از این دو مورد اقدامی در محیط عملیاتی انجام شود:
وجود فایل بکاپ به تنهایی کافی نیست. پیش از شروع تعویض دیسک، باید آخرین نسخه پشتیبان کامل از دیتابیس ها و ماشین های مجازی بررسی و وضعیت سلامت آن (Consistency Check) تایید شود. در صورتی که آرایه در وضعیت بحرانی باشد، تهیه نسخه پشتیبان سرد یا فوری پیش از هر حرکت فیزیکی الزامی است.
بررسی کنسول مدیریتی (مانند Smart Storage Administrator یا MegaRAID) برای تشخیص دقیق وضعیت دیسک ها الزامی است. اگر آرایه در وضعیت تنزل یافته (Degraded) باشد، خروج اشتباه یک دیسک سالم دیگر می تواند کل Volume را به حالت Failed ببرد و داده ها را غیرقابل دسترس کند.
مولفه های کلیدی و الزامات فنی در فرایند تعویض
مدیریت موفق تعویض درایوها مستلزم شناخت عمیق تفاوتهای تکنولوژیک و رعایت سازگاری چندجانبه میان دیسک، شاسی و کنترلر است:
تعویض درایوهای مکانیکی معمولا به دلیل خطاهای پیش بینی شده در گزارش های S.M.A.R.T یا بدسکتورهای فیزیکی انجام می شود. درایوهای سازمانی با سرعت چرخش ۱۰K یا ۱۵K دور در دقیقه لرزش های محیطی خاصی ایجاد می کنند و باید دقیقا درون کدی (Caddy) و ریل های استاندارد پیچ شوند تا ارتعاش دیسک های مجاور باعث خطای خواندن نشود.
درایوهای Enterprise SAS/SATA و NVMe SSD دارای شاخص طول عمر مبتنی بر استهلاک سلول ها (Endurance / DWPD) هستند. در صورت اتمام درصد سلامت سلول های فلش، تعویض باید برنامه ریزی شود. به کار بردن درایوهای رده مصرف کننده (Consumer) به دلیل نداشتن مدار محافظ قطع برق (PLP) در سرور ریسک از دست رفتن کش را بالا می برد.
پس از قرارگیری دیسک جدید، عملیات بازسازی اطلاعات (Rebuild) آغاز می شود. این فرایند فشار خواندن بالایی روی سایر دیسک های باقیمانده وارد می کند. سرعت ریبیلد در کنترلر باید بر اساس ساعت کاری سازمان تنظیم شود تا افت کارایی سرویس ها به حداقل برسد و همزمان بازه آسیب پذیری به درازا نکشد.
قابلیت تعویض درایو بدون خاموش کردن سرور، نیازمند بک پلین (Backplane) و قفسه های پشتیبانی کننده است. تکنسین باید رفتار ال ای دی های وضعیت درایو (آبی، زرد، قرمز یا چشمک زن) را به درستی تفسیر کند. خارج کردن دیسک اشتباه در شرایط آنلاین خطای انسانی رایج و خطرناکی است که باید با بررسی آدرس فیزیکی (Bay ID) مهار شود.
ظرفیت دیسک جدید باید برابر یا بزرگتر از کمترین ظرفیت موجود در اعضای آرایه باشد. اگر دیسک با ظرفیت بالاتر جایگزین شود، فضای اضافه تا زمان تعویض تمامی دیسک ها بلااستفاده می ماند. همچنین نوع قالب بندی سکتورها (512n یا 512e در برابر 4Kn) باید بررسی شود تا ناسازگاری لایه بلاک رخ ندهد.
هر دیسک فیزیکی روی سرورهای سازمانی قابل نصب نیست. تطبیق اینترفیس (SAS در برابر SATA)، ولتاژ خطوط برق بک پلین و فریمور رسمی سازنده سرور برای دیسک الزامی است. عدم وجود فریمور سازگار می تواند باعث شود سنسور دمای درایو توسط سیستم خوانده نشده و فن های سرور با حداکثر توان کار کنند.
رویکرد مسئولانه مهندسی در مدیریت ذخیره سازها
ارائه هرگونه توصیه کلی، تضمین های شتاب زده و اقدامات بدون شناخت نقشه اتصال کابل ها، کانفیگ کنترلر و نوع سیستم فایل در تجهیزات ذخیره ساز مردود است. در سناریوهای پیچیده که چندین درایو رفتارهای غیرعادی نشان می دهند، ابتدا باید تست های نرم افزاری غیرتخریبی صورت گیرد و پس از اطمینان از سلامت مخزن پشتیبان و تایید پنجره نگهداری، اقدامات سخت افزاری با صبر و مرحله به مرحله انجام پذیرد تا سرویس های سازمان با کمترین تنش به فعالیت خود ادامه دهند.
نگهداری پیشگیرانه سخت افزار سرور
خرابی سخت افزارها تقریبا هیچ گاه بدون هشدار قبلی اتفاق نمی افتد؛ بلکه تجهیزات پیش از فروپاشی، نشانه های ریز و سیگنال های اولیه ای مانند افزایش مقاومت حرارتی، نوسان دور فن ها یا خطاهای سکتور در کنترلر ثبت می کنند. رویکرد مدرن در مدیریت مراکز داده و رک های سازمانی، عبور از مدل سنتی تعمیر پس از خرابی و حرکت به سمت پایش مداوم و کشف زودهنگام ریسک ها است.
هدف راهبردی: مهار ریسک قبل از تبدیل شدن به توقف سرویس (Downtime)
توقف ناگهانی سرورهای حیاتی هزینه های سنگین مالی، آسیب به اعتبار سازمان و از دست رفتن داده های در حال تبادل را به همراه دارد. هدف از نگهداری پیشگیرانه سخت افزار (Preventive Maintenance)، شناسایی نشانه های پنهان استهلاک و خطاهای سطحی پیش از تشدید و تبدیل آنها به توقف کامل سرویس است. با این شیوه، هرگونه قطعه فرسوده یا تنظیم نامناسب در قالب اقدامات از پیش برنامه ریزی شده مدیریت می شود.
شاخص ها و مراحل کلیدی پایش سلامت سخت افزار
فرایند نگهداری دورهای بر پایه ارزیابی عمیق سنسورها، سیستم های خنک کننده، مدارات تغذیه و محیط فیزیکی استوار است:
پایش سنسورهای دمایی پردازنده، چیپست ها، حافظه های رم و کنترلرهای ذخیره ساز. افزایش تدریجی حرارت معمولا نشانه ای از خشک شدن خمیر سیلیکون، افت راندمان هیت سینک یا تداخل در گردش جریان هوای داخل شاسی است که می تواند به خاموشی اضطراری سیستم منجر شود.
ارزیابی سلامت دور موتور فن ها (RPM)، بررسی لرزش های مکانیکی ناشی از خرابی بلبرینگ و وضعیت ماژول های Redundant Fan. فن هایی که با صدای غیرعادی کار می کنند یا دور آنها نوسان مداوم دارد، مستعد قفل شدن هستند و جریان باد را مختل می کنند.
بررسی ولتاژهای خروجی ریل های مختلف، بازدهی انرژی و عملکرد سوئیچینگ خودکار در پاورهای افزونه (Redundant). بررسی اطمینان از توزیع متوازن بار جریان و فعال بودن هشدارهای زودهنگام در صورت افت خازن ها یا دمای غیرعادی ماژول تغذیه.
استخراج داده های تحلیلی S.M.A.R.T دیسک های HDD و SSD، ارزیابی سکتورهای بازتخصیص یافته (Reallocated Sectors)، خطاهای CRC اینترفیس و درصد استهلاک سلول های حافظه فلش (Wear Out Percentage) جهت برنامه ریزی تعویض قبل از خرابی قطعی دیسک.
پایش وضعیت لاجیکال درایوها، سلامت باتری پشتیبان کش (BBU/SuperCap) و اطمینان از سلامت دیسک های یدکی (Hot Spare). بررسی هماهنگی داده های برابری (Parity Consistency) برای جلوگیری از ایجاد ناسازگاری های داده ای پنهان در آرایه ها.
بررسی سیستم ثبت رویدادهای سرور نظیر HP IML یا Dell SEL. ثبت خطاهای اصلاح شده رم (Correctable ECC Errors)، تداخل های گذرگاه PCIe و ریست های جزیی که معمولا سیگنال های اولیه از استهلاک یک چیپست یا ماژول سخت افزاری هستند.
تطبیق نسخه های فریمور BIOS، کارت های شبکه، ماژول های ذخیره ساز و کنسول های ریموت با آخرین بسته های پایدار و معتبر منتشر شده توسط سازنده. رفع باگ های شناخته شده، بهبود مدیریت توان مصرفی و بستن روزنه های امنیتی در سطح ریزکدها.
سنجش نرخ رشد ذخیره سازها، منابع پردازشی و مصرف رم در بازه های ماهانه و فصلی. پیش بینی زمان تکمیل ظرفیت استوریج یا پر شدن رم ماشین های مجازی به مدیران این امکان را می دهد که قبل از وقوع بحران، فرآیند ارتقا یا پاکسازی را تدوین کنند.
ارزیابی زنجیره پشتیبان گیری، اطمینان از موفقیت Jobهای زمان بندی شده، سلامت فضای ذخیره ساز بکاپ و اجرای تست های بازیابی دوره ای (Restore Test). اطمینان از اینکه در صورت بحرانی ترین خرابی فیزیکی، نسخه های سالم خارج از محیط سرور اصلی در دسترس هستند.
ارزیابی دمای محیطی رک (Cold Aisle و Hot Aisle)، درصد رطوبت نسبی، عملکرد سیستم های خنک کننده دقیق (In-Row یا اسپلیت)، عاری بودن فضای رک از گرد و غبار، نحوه عبور کابل ها بدون انسداد مسیر باد و بررسی سلامت سیستم های اعلام و اطفای حریق و اتصال به زمین (ارتینگ).
پشتیبانی سخت افزار سرور
در نگاه سازمانی به فناوری اطلاعات، تفکیک میان یک اقدام مقطعی با یک فرایند پیوسته اهمیت بنیادین دارد. بسیاری از سازمان ها خدمات سخت افزاری را تنها با مداخله هنگام خرابی اشتباه می گیرند، در حالی که حفظ تداوم کسب و کار به برنامه ای فراتر از واکنش های پس از حادثه نیازمند است.
تفاوت بنیادین تعمیر با پشتیبانی و نگهداری
این دو مفهوم از نظر بازه اثرگذاری، زمان مداخله و شیوه مدیریت ریسک در دو نقطه کاملا متمایز قرار می گیرند:
تعمیر یک کنش واکنشی (Reactive) است که دقیقا در زمان وقوع خرابی و پس از بروز قطعی رخ می دهد. هدف از تعمیر صرفا احیای سیستم آسیب دیده، رفع عیب مدار یا جایگزینی ماژول سوخته در شرایط اضطراری است. این رویکرد به تنهایی نمی تواند مانع از داون تایم شود چون زمانی آغاز می شود که سرویس از مدار خارج شده است.
پشتیبانی یک فرایند جامع، پیشگیرانه (Proactive) و مدیریت شده است که تمام چرخه عمر سخت افزار را پوشش می دهد. این رویکرد پیش از خرابی با پایش و بازدید، هنگام خرابی با واکنش فوری و کنترل بحران، و بعد از خرابی با تحلیل ریشه ای علل و بازسازی پایداری همراه است تا از تکرار حادثه جلوگیری شود.
دامنه فرایندهای پشتیبانی و نگهداری سخت افزار سرور
یک ساختار استاندارد پشتیبانی سخت افزاری شامل مجموعه ای از فرایندهای به هم پیوسته است که ریسک های فنی را به حداقل می رساند:
رصد پیوسته شاخص های سخت افزاری از طریق کنسول های مدیریتی و پروتکل های نظارتی. ثبت لحظه ای وضعیت سنسورها، خطاهای احتمالی لاجیکال درایوها و وضعیت ارتباطات فیزیکی بدون ایجاد بار پردازشی اضافی بر سرور.
حضور منظم کارشناس در محل رک برای بررسی چشمی و فیزیکی. ارزیابی وضعیت ال ای دی های هشدار شاسی، صدای گردش بلبرینگ فن ها، جریان هوای ورودی و خروجی و بررسی اتصالات کابل های تغذیه و دیتا.
اجرای آزمون های استاندارد تشخیصی برای ارزیابی راندمان ماژول های حافظه، تست کارایی کنترلر رید، اندازه گیری دقیق ولتاژهای پاور و سنجش سلامت سلول های ذخیره ساز جهت کشف گلوگاه ها.
شناسنامه دار کردن تمامی قطعات سرور با شماره سریال، پارت نامبر و تاریخ ورود به مدار. مشخص بودن دقیق اسلات قرارگیری هر ماژول رم، پردازنده و درایو برای پیشگیری از ناهماهنگی در توسعه های آتی.
ثبت دقیق نقشه کابل کشی رک، دیاگرام ارتباط با سوئیچ ها، تنظیمات بایوس، نسخه های سیستم عامل مدیریتی و لاگ تغییرات سخت افزاری. دسترسی به مستندات سرعت عیب یابی در شرایط بحران را چند برابر می کند.
تعیین تقویم دقیق برای پنجره های تعمیراتی (Maintenance Windows)، سرویس دوره ای غبارزدایی، آپدیت های برنامه ریزی شده فریمور و تعویض پیشگیرانه قطعات مصرفی مانند باتری کش رید کنترلر و فیلترهای شاسی.
مدیریت ارتباط با آزمایشگاه ها و تکنسین های ارشد در زمان بروز خرابی قطعی، تنظیم زمان خروج تجهیز بدون توقف سرویس های عملیاتی، جایگزینی قطعه موقت و نظارت کامل بر کیفیت تست پس از تعمیر.
ارائه راهکارهای کارشناسی برای توسعه منطقی سرور بر اساس تحلیل بار کاری. پیشنهاد افزایش ظرفیت رم یا افزودن درایوهای پرسرعت با در نظر گرفتن حداکثر سازگاری برد اصلی و نرخ بازگشت سرمایه.
برنامه ریزی برای تامین به موقع قطعات یدکی بحرانی (Spare Parts) نظیر پاور یدک، فن های سازگار و هارد دیسک های هم رده جهت به حداقل رساندن زمان انتظار و جلوگیری از توقف طولانی سرور در شرایط حاد.
خدمات سخت افزاری سرور و کامپیوتر چه تفاوتی دارند؟
اگرچه کامپیوترهای رومیزی و سرورها هر دو از اجزای سخت افزاری بنیادین مانند پردازنده، حافظه رم، برد اصلی و دیسک های ذخیره سازی تشکیل شده اند، اما رسالت عملیاتی و حساسیت کاری آنها در دو سطح کاملا متفاوت تعریف می شود. شناخت این تمایزها تعیین کننده روش نگهداری، سطح استاندارد قطعات تعویضی و زمان بندی مداخلات فنی است.
جدول مقایسه شاخص های سخت افزاری و نگهداری
تفاوت های ساختاری و الزامات عملیاتی میان سیستم های اداری و سرورهای پردازشی سازمانی:
| مورد | کامپیوتر | سرور |
|---|---|---|
| اهمیت سرویس | معمولی تا بالا | معمولا بالا |
| RAID | معمولا محدود | متداول |
| Redundancy | محدود | مهم |
| Power | عادی | ممکن است Redundant باشد |
| Storage | ساده تر | پیچیده تر |
| Downtime | وابسته به کاربر | ممکن است روی چند سرویس اثر بگذارد |
| نگهداری | دوره ای | معمولا منظم تر |
توقف عملکرد یک کامپیوتر رومیزی معمولا جریان کاری یک کاربر را مختل می کند، اما خاموشی یا خطای فیزیکی در یک سرور میزبان می تواند ده ها ماشین مجازی، پایگاه های داده اشتراکی، سیستم های حسابداری و اتوماسیون کل پرسنل شرکت را با وقفه روبه رو سازد.
در کامپیوترها خرابی پاور یا قطع یک ماژول به معنای توقف کامل دستگاه است. در طراحی سرور، وجود پاورهای دوبل، فن های ماژولار مازاد و آرایه های دیسک با هدف تاب آوری پیوسته تعبیه شده اند تا سیستم هنگام خرابی یک قطعه به کار خود ادامه دهد.
ذخیره ساز کامپیوتر معمولا از یک یا دو درایو ساده تشکیل شده است، در حالی که استوریج سرور شامل آرایه های پیشرفته رید، سطوح کش مجهز به خازن های محافظتی، کابل کشی بک پلین اختصاصی و قابلیت تعویض آنلاین قطعات بدون توقف شاسی است.
نیاز به سنجش سلامت و پشتیبانی سخت افزار سرور دارید؟
پیش از بروز وقفه ناخواسته در سرویس ها، زیرساخت پردازشی خود را به صورت تخصصی ارزیابی کنید. تیم فنی ایران هلپ دسک آماده پاسخگویی و ارائه مشاوره کارشناسی است.
فرآیند گام به گام تعمیر سخت افزار سرور
تعمیر و عیب یابی سخت افزار بر اساس متدولوژی مهندسی برای کاهش زمان توقف سرویس و جلوگیری از حذف تصادفی داده ها اجرا می شود.
ثبت خرابی و جمع آوری علائم
شرح دقیق رفتارهای غیرعادی، خطاهای سیستمی، کدهای اعلامی لاگ ها و زمان دقیق وقوع رخداد در سامانه پشتیبانی مستند می شود.
بررسی اولیه و لاگ خوانی
تحلیل وضعیت چراغ های هشدار شاسی، بررسی لاگ های سطح فریمور و سامانه های مدیریتی نظیر iLO و iDRAC جهت سنجش دامنه اختلال.
تشخیص قطعه و علت ریشه ای
اجرای آزمون های سخت افزاری مستقل جهت تفکیک ایراد میان کنترلر رید، ماژول های حافظه، پاور، دیسک ها یا برد اصلی دستگاه.
بررسی Backup و ریسک اطلاعات
ارزیابی کامل وضعیت آخرین نسخه پشتیبان، تست سلامت آرایه رید و تخمین ضریب ریسک قبل از باز کردن فیزیکی یا تغییر کانفیگ.
پیشنهاد تعمیر، تعویض یا ارتقا
ارائه گزارش فنی مکتوب و مقایسه هزینه و زمان میان تعمیر بورد، تعویض قطعه با پارت اورجینال یا جایگزینی با قطعه ارتقایافته.
اجرای تعمیر و تعویض استاندارد
جایگزینی قطعه معیوب با رعایت الزامات ضد الکتریسیته ساکن، سازگاری دقیق فرم ور، کالیبراسیون و همگام سازی مجدد آرایه ها.
تست پایداری زیر بار (Stress Test)
اجرای آزمایش های حرارتی، ارزیابی توان مصرفی، تست یکپارچگی خواندن و نوشتن دیسک ها برای اطمینان از رفع کامل نوسان و خطا.
تحویل رسمی و مستندسازی شناسه
ثبت شماره سریال قطعه جدید در پرونده تجهیزات اتاق سرور، به روزرسانی ماتریس دارایی های شبکه و تحویل با گزارش رسمی به کارفرما.
نیاز به هماهنگی برای بررسی فوری سرور دارید؟
تیم فنی ایران هلپ دسک با در اختیار داشتن ابزارهای تشخیصی و قطعات جایگزین، آمادگی بررسی فوری سرورهای سازمانی را دارد.
قبل از تعمیر سرور چه مواردی باید بررسی شود؟
قبل از تعمیر سرور باید وضعیت سرویس، Backup، Storage/RAID، علائم خرابی و وابستگی سرویس ها بررسی شود تا تعمیر باعث از دست رفتن اطلاعات یا توقف غیرضروری سرویس نشود.
وضعیت Backup
اطمینان قطعی از صحت آخرین نسخه پشتیبان، تست موفقیت آمیز بازیابی و انتقال فایل های پشتیبان به فضایی کاملا مستقل از شاسی.
وضعیت RAID
بررسی سلامت کنترلر، شناسایی وضعیت دیسک های Optimal یا Degraded و اطمینان از آماده بودن کش و باتری کش کنترلر پیش از باز کردن سیستم.
سرویس های فعال
تهیه فهرست از تمام ماشین های مجازی، پایگاه داده ها و رول های مستقر بر روی سرور جهت جلوگیری از قطع ناگهانی تبادلات در جریان.
وابستگی ها
تحلیل سرویس های متصل در شبکه نظیر اکتیو دایرکتوری، DNS، ارتباط با استوریج شبکه و روترها برای ممانعت از اختلال دومینووار.
تحلیل Log
استخراج گزارش های سیستم عامل، رویدادهای هسته (System Event Log) و لاگ های بورد مدیریت پیش از خاموش کردن یا ریستارت سرور.
Hardware Error
خوانش کدهای هشدار دهنده از محیط های iLO و iDRAC، تطبیق الگوهای چراغ های عیب یابی شاسی و ثبت قطعی سنسورهای حرارتی.
Downtime Window
تعیین بازه زمانی مجاز برای خاموشی سرویس، اطلاع رسانی رسمی به کاربران سازمانی و هماهنگی خارج از ساعات اوج کاری.
قطعه جایگزین
بررسی وجود قطعه یدکی کاملا تست شده، تطبیق دقیق پارت نامبر و اطمینان از سازگاری فریم ور پیش از آغاز عملیات فیزیکی تعویض.
اجرای این چک لیست از خطاهای جبران ناپذیر در سرورهای سازمانی جلوگیری می کند.
هزینه تعمیر سخت افزار کامپیوتر و سرور
محاسبه هزینه خدمات نگهداری و تعمیر تجهیزات پردازشی بر اساس پیچیدگی فنی، استانداردهای سازمان نظام صنفی رایانه ای و متغیرهای حیاتی زیرساخت انجام می گیرد.
نحوه محاسبه و اعلام قیمت قطعی خدمات
هزینه نهایی تعمیرات سخت افزاری تنها پس از پذیرش، بازبینی حضوری یا در محل، تست دقیق قطعات آسیب دیده و مشخص شدن دقیق نوع خدمت (تعمیر برد، تعویض قطعه یا تنظیمات مداری) اعلام می گردد. تعرفه های مصوب پایه به عنوان حداقل دستمزد فنی مبنا قرار گرفته و در سیستم های حساس سازمانی نیازمند ارزیابی ریسک است.
عوامل موثر بر تعیین هزینه تعمیرات سخت افزار
نوع دستگاه
تفاوت ساختاری کامپیوتر رومیزی، آل این وان، لپ تاپ و سرورهای چند یونیت در بازوبست و دسترسی به قطعات.
نوع خرابی
نوسانات الکتریکی برد، قطعی فیزیکی، نقص چیپست ها، استهلاک مکانیکی هارد و فن یا خطاهای فریم ور.
مدل سرور
نسل شاسی (مانند اچ پی نسل 8 تا 11)، ابعاد یونیت، نوع کنترلر ذخیره ساز و تراکم اجزای سخت افزاری.
برند تجهیزات
تفاوت معماری اپل مک، سرورهای HPE، دل، لنوو و تفاوت قیمت ابزارها و لایسنس های اختصاصی عیب یابی.
قطعه مورد نیاز
نوسانات الکتریکی برد، قطعی فیزیکی، نقص چیپست ها، استهلاک مکانیکی هارد و فن یا خطاهای فریم ور.
مدل سرور
نسل شاسی (مانند اچ پی نسل 8 تا 11)، ابعاد یونیت، نوع کنترلر ذخیره ساز و تراکم اجزای سخت افزاری.
برند تجهیزات
تفاوت معماری اپل مک، سرورهای HPE، دل، لنوو و تفاوت قیمت ابزارها و لایسنس های اختصاصی عیب یابی.
قطعه مورد نیاز
نوع قطعه اعم از پردازنده آنبورد، مادربرد سرور، ماژول های رم رجیسترد، دیسک های SAS یا منبع تغذیه ریداندنت.
زمان مورد نیاز
مدت زمان تست پایداری زیر بار کامل کاری پس از اتمام تعمیرات و لزوم پاسخگویی در ساعات غیراداری یا شیفت های اضطراری.
وضعیت Backup
وجود یا عدم وجود پشتیبان معتبر و لزوم کلون کردن بیت به بیت دیسک ها پیش از دستکاری سخت افزار جهت صیانت از داده ها.
حساسیت سرویس
وابستگی زیرساخت سازمان، سرویس های دیتابیس مالی یا ماشین های مجازی که توقف آنها نیازمند تعهدات SLA ویژه است.
تعرفه و هزینه تعمیر کامپیوتر مک (Apple Mac)
سند 4.pdf | جدول 24-3 (ارزش تا 400 میلیون ریال، عمر بیش از 5 سال)| شرح خدمت تخصصی سخت افزار مک | هزینه مصوب (ریال) | ملاحظات فنی |
|---|---|---|
| باز و بست کلی رایانه اپل (Mac) | 27,000,000 ریال | به ردیف های تعمیراتی اضافه می شود |
| سرویس کامل دستگاه اپل مک | 10,500,000 ریال | تمیزکاری داخلی، تعویض خمیر و پد حرارتی |
| تعمیر مداری سطح 1 مک | 42,500,000 ریال | رفع ایرادات تغذیه و المان های سطحی |
| تعمیر مداری سطح 2 مک | 80,500,000 ریال | مدارهای پیچیده تر و تعویض آی سی های ثانویه |
| تعمیر مداری سطح 3 مک | 134,000,000 ریال | تخصصی ترین سطح تعمیرات منطقی و تغذیه برد |
| تعویض پردازنده آنبورد (CPU Onboard) | 53,000,000 ریال | عملیات حساس BGA و تعویض چیپ پردازنده |
تعرفه و هزینه تعمیر کامپیوتر آل این وان (All-in-One)
اسناد 1.pdf و 2.pdf | جداول 10-3 و 11-3| شرح خدمت سخت افزاری آل این وان | رده قیمتی کمتر از 500 میلیون ریال | رده قیمتی 500 تا 800 میلیون ریال |
|---|---|---|
| سرویس کامل دستگاه All-in-One | 13,000,000 ریال | 16,000,000 ریال |
| تعمیر فن، هارد دیسک و کارت های جانبی | 13,000,000 ریال | طبق ارزیابی قطعه |
| تعویض پنل تصویر (LCD) | 21,000,000 ریال | 27,000,000 ریال |
| تعویض تاچ اسکرین (Touch) | 42,500,000 ریال | 53,000,000 ریال |
| تعمیر مادربرد آل این وان سطح 1 | 10,500,000 ریال | بر اساس بازبینی فنی |
| تعمیر مادربرد آل این وان سطح 2 | 27,000,000 ریال | بر اساس بازبینی فنی |
| تعمیر مادربرد آل این وان سطح 3 | 48,000,000 ریال | بر اساس بازبینی فنی |
| تعمیر و ترمیم قاب دستگاه | تا 40 درصد ارزش روز قاب آل این وان | |
تعرفه خدمات سخت افزاری و تعمیر قطعات کامپیوتر شخصی (PC)
سند 5.pdf | جداول 36-3 و 37-3| نوع خدمت و قطعه سخت افزاری PC | هزینه مصوب پایه (ریال) | مبنای محاسبه تکمیلی |
|---|---|---|
| تعمیر درایو نوری (ODD) | 2,850,000 ریال | اجرت تعمیر مکانیکی و الکترونیکی |
| تعمیر منبع تغذیه (پاور معمولی) | بر اساس درصد ارزش | تا 30 درصد ارزش کل برد پاور |
| تعمیر مانیتور کامپیوتر | بر اساس درصد ارزش | تا 40 درصد ارزش کل برد مانیتور |
| تعمیر مودم، روتر و اکسس پوینت | بر اساس درصد ارزش | تا 25 درصد ارزش برد تجهیز ارتباطی |
| نصب کارت سخت افزاری و هارد دیسک | 2,100,000 ریال | بدون جابجایی و انتقال اطلاعات کاربری |
| نصب کارت های حرفه ای، SCSI، SAS و RAID Controller | 8,000,000 ریال | شامل کنترلرهای تخصصی ذخیره ساز و شبکه |
| مونتاژ کامل PC به همراه نصب سیستم عامل و نرم افزار پایه | 14,000,000 ریال | اسمبل دقیق، کابل کشی، نصب ویندوز و آفیس |
وضعیت تعرفه تعمیر لپ تاپ (Laptop)
در صفحات تعرفه ارائه شده ردیف مشخصی با عنوان تعمیر لپ تاپ درج نشده است. هزینه تعمیرات لپ تاپ بر اساس مدل مادربرد، نسل دستگاه، وضعیت مدارهای تغذیه و نیازمندی تعویض قطعات (چیپ گرافیک، پورت شارژ و صفحه نمایش) پس از ثبت پذیرش و بررسی آزمایشگاهی محاسبه می شود.
وضعیت تعرفه تعمیر سخت افزار سرور (Server)
به دلیل ابعاد، ارزش بالا و پیچیدگی اختصاصی ریدکنترلرها، مادربردهای چند سوکت و منابع تغذیه ریداندنت سرور، هیچ نرخ مصوب خطی و یکسانی وجود ندارد. هزینه تعمیرات سرورهای سازمانی مستلزم بررسی مدل شاسی، علائم لاگ های مدیریتی و تایید پنجره زمانی Downtime است.
پشتیبانی سخت افزار به صورت قراردادی
در مدل سنتی پشتیبانی، سازمان ها تنها زمانی اقدام می کنند که قطعه ای بسوزد یا سروری از کار بیفتد. این واکنش دیرهنگام موجب توقف عملیات، تحمیل هزینه های اضطراری و ریسک از دست رفتن داده ها می شود. در قراردادهای دوره ای، برنامه منظم نگهداری پیشگیرانه جایگزین برخورد واکنشی پس از خرابی می گردد.
مدل واکنشی (تعمیر بعد از خرابی)
توقف ناگهانی سرویس های کاری، بی اطلاعی از استهلاک پنهان قطعات، توقف طولانی مدت پرسنل برای پیدا کردن قطعه یدکی نایاب و تحمیل نرخ های گزاف برای خدمات فوری بدون تعهد زمانی مشخص.
مدل قراردادی (نگهداری پیشگیرانه مستمر)
پایش سلامت قطعات پیش از سوختن، بازبینی دوره ای فن ها، خمیرهای حرارتی، دیسک های رید و منابع تغذیه، تعهد سطح خدمات معین (SLA) و به حداقل رسیدن زمان خواب سیستم های پردازشی.
تجهیزات و لایه های تحت پوشش در پشتیبانی قراردادی
کامپیوتر کاربران
کنترل پایداری منبع تغذیه، سلامت دیسک های ذخیره سازی، رفع حرارت بیش از حد پردازنده ها، ارتقای ماژول های رم و سرویس های فیزیکی قطعات ایستگاه های کاری پرسنل.
سرورها
پایش تخصصی شاسی های رکمونت و تاور، بررسی ماژول های تغذیه ریداندنت، فن های دور متغیر، سلامت کنترلرهای رید، عیب یابی بردهای سروری و خواندن لاگ های عمیق ILO و iDRAC.
ذخیره سازها (Storage)
نگهداری تخصصی استوریج های SAN و NAS، بررسی وضعیت کش و سلامت باتری کنترلرها، پیش بینی دیسک های در آستانه خرابی و جلوگیری از تخریب آرایه های رید در استوریج های سازمانی.
تجهیزات شبکه
بررسی فن ها و منابع تغذیه سوییچ های لایه دو و سه، روترها، فایروال های سخت افزاری و کنترل پایداری فیزیکی ماژول های فیبر نوری و اتصالات پچ پنل ها.
منابع تغذیه اضطراری (UPS)
ارزیابی سلامت باتری ها، تست دوره ای توان زیر بار، تمیزکاری بردهای داخلی اینورتر، بررسی کالیبراسیون و تضمین سوئیچ بدون وقفه برق در زمان قطعی های شبکه سراسری.
تجهیزات محیطی اتاق سرور
بررسی سیستم های خنک کننده اتاق سرور، سنسورهای رطوبت و دما، پایانه های توزیع برق (PDU)، چینش استاندارد و ایمنی جریان هوای گرم و سرد در داخل رک ها.
مزایای پشتیبانی قراردادی سخت افزار
عقد قرارداد رسمی نگهداری سخت افزار، مدیریت بخش انفورماتیک سازمان را از یک وضعیت نامطمئن و پرهزینه به فرایندی شفاف، قابل پیش بینی و مهندسی شده تبدیل می کند.
برنامه نگهداری منظم
اجرای زمان بندی شده سرویس های فیزیکی، سرویس دوره ای فن ها، تعویض خمیر سیلیکون، بررسی جریان هوا و غبارزدایی قبل از رسیدن قطعات به آستانه خطای حرارتی.
ثبت دقیق سوابق تجهیزات
تشکیل شناسنامه فنی برای هر دستگاه، ثبت تمامی تعمیرات انجام شده، قطعات تعویضی، ساعات کارکرد و طول عمر کارخانه ای قطعات مصرفی.
شناخت عمیق تر از زیرساخت
تسلط کامل تیم فنی بر توپولوژی فیزیکی، نوع کابل کشی ها، معماری اتصال دیسک ها و شناسایی نقاط ضعف یا گلوگاه های سخت افزاری که در مراجعات پراکنده قابل تشخیص نیستند.
پاسخگویی و SLA مشخص
تعهد حقوقی به زمان پاسخ دهی (Response Time)، زمان حضور کارشناس در محل سازمان و مسئولیت پذیری مستمر در قبال رفع خرابی بدون سردرگمی های معمول اداری.
ارائه گزارش های منظم وضعیت
ارائه گزارش های دوره ای مکتوب از وضعیت سلامت فیزیکی قطعات، دمای کاری، سابقه خطاهای ثبت شده در کنترلرها و نرخ پایداری سرورها به مدیران ارشد سازمان.
برنامه ریزی برای تامین قطعه و ارتقا
پیش بینی به موقع قطعات در حال فرسودگی، تهیه به موقع قطعات جایگزین و تنظیم بودجه بندی ارتقای تجهیزات قبل از توقف ناگهانی و شوک های مالی به مجموعه.
پشتیبانی سخت افزار به صورت قراردادی
در مدل سنتی پشتیبانی، سازمان ها تنها زمانی اقدام می کنند که قطعه ای بسوزد یا سروری از کار بیفتد. این واکنش دیرهنگام موجب توقف عملیات، تحمیل هزینه های اضطراری و ریسک از دست رفتن داده ها می شود. در قراردادهای دوره ای، برنامه منظم نگهداری پیشگیرانه جایگزین برخورد واکنشی پس از خرابی می گردد.
مدل واکنشی (تعمیر بعد از خرابی)
توقف ناگهانی سرویس های کاری، بی اطلاعی از استهلاک پنهان قطعات، توقف طولانی مدت پرسنل برای پیدا کردن قطعه یدکی نایاب و تحمیل نرخ های گزاف برای خدمات فوری بدون تعهد زمانی مشخص.
مدل قراردادی (نگهداری پیشگیرانه مستمر)
پایش سلامت قطعات پیش از سوختن، بازبینی دوره ای فن ها، خمیرهای حرارتی، دیسک های رید و منابع تغذیه، تعهد سطح خدمات معین (SLA) و به حداقل رسیدن زمان خواب سیستم های پردازشی.
تجهیزات و لایه های تحت پوشش در پشتیبانی قراردادی
کامپیوتر کاربران
کنترل پایداری منبع تغذیه، سلامت دیسک های ذخیره سازی، رفع حرارت بیش از حد پردازنده ها، ارتقای ماژول های رم و سرویس های فیزیکی قطعات ایستگاه های کاری پرسنل.
سرورها
پایش تخصصی شاسی های رکمونت و تاور، بررسی ماژول های تغذیه ریداندنت، فن های دور متغیر، سلامت کنترلرهای رید، عیب یابی بردهای سروری و خواندن لاگ های عمیق ILO و iDRAC.
ذخیره سازها (Storage)
نگهداری تخصصی استوریج های SAN و NAS، بررسی وضعیت کش و سلامت باتری کنترلرها، پیش بینی دیسک های در آستانه خرابی و جلوگیری از تخریب آرایه های رید در استوریج های سازمانی.
تجهیزات شبکه
بررسی فن ها و منابع تغذیه سوییچ های لایه دو و سه، روترها، فایروال های سخت افزاری و کنترل پایداری فیزیکی ماژول های فیبر نوری و اتصالات پچ پنل ها.
منابع تغذیه اضطراری (UPS)
ارزیابی سلامت باتری ها، تست دوره ای توان زیر بار، تمیزکاری بردهای داخلی اینورتر، بررسی کالیبراسیون و تضمین سوئیچ بدون وقفه برق در زمان قطعی های شبکه سراسری.
تجهیزات محیطی اتاق سرور
بررسی سیستم های خنک کننده اتاق سرور، سنسورهای رطوبت و دما، پایانه های توزیع برق (PDU)، چینش استاندارد و ایمنی جریان هوای گرم و سرد در داخل رک ها.
مزایای پشتیبانی قراردادی سخت افزار
عقد قرارداد رسمی نگهداری سخت افزار، مدیریت بخش انفورماتیک سازمان را از یک وضعیت نامطمئن و پرهزینه به فرایندی شفاف، قابل پیش بینی و مهندسی شده تبدیل می کند.
برنامه نگهداری منظم
اجرای زمان بندی شده سرویس های فیزیکی، سرویس دوره ای فن ها، تعویض خمیر سیلیکون، بررسی جریان هوا و غبارزدایی قبل از رسیدن قطعات به آستانه خطای حرارتی.
ثبت دقیق سوابق تجهیزات
تشکیل شناسنامه فنی برای هر دستگاه، ثبت تمامی تعمیرات انجام شده، قطعات تعویضی، ساعات کارکرد و طول عمر کارخانه ای قطعات مصرفی.
شناخت عمیق تر از زیرساخت
تسلط کامل تیم فنی بر توپولوژی فیزیکی، نوع کابل کشی ها، معماری اتصال دیسک ها و شناسایی نقاط ضعف یا گلوگاه های سخت افزاری که در مراجعات پراکنده قابل تشخیص نیستند.
پاسخگویی و SLA مشخص
تعهد حقوقی به زمان پاسخ دهی (Response Time)، زمان حضور کارشناس در محل سازمان و مسئولیت پذیری مستمر در قبال رفع خرابی بدون سردرگمی های معمول اداری.
ارائه گزارش های منظم وضعیت
ارائه گزارش های دوره ای مکتوب از وضعیت سلامت فیزیکی قطعات، دمای کاری، سابقه خطاهای ثبت شده در کنترلرها و نرخ پایداری سرورها به مدیران ارشد سازمان.
برنامه ریزی برای تامین قطعه و ارتقا
پیش بینی به موقع قطعات در حال فرسودگی، تهیه به موقع قطعات جایگزین و تنظیم بودجه بندی ارتقای تجهیزات قبل از توقف ناگهانی و شوک های مالی به مجموعه.
چرا نگهداری پیشگیرانه مهم است؟
هیچ سیستمی بدون خطا کار نمی کند و نگهداری پیشگیرانه به معنای به صفر رساندن استهلاک فیزیکی نیست. هدف این متدولوژی، تبدیل توقف های فاجعه بار و پیش بینی نشده به عملیات های تحت کنترل، برنامه ریزی شده و ایمن است.
شناسایی نشانه های خرابی
قطعات الکترونیکی و مکانیکی پیش از سوختن کامل، علائم فنی مشخصی بروز می دهند. بررسی کدهای خطای SMART در هاردها، افت ولتاژ خروجی پاورها، لرزش شفت فن ها و تغییرات دمایی کنترلرها نشانه هایی هستند که قبل از قفل شدن سرور قابل ردیابی و اقدام خواهند بود.
کاهش ریسک توقف
توقف ناگهانی شاسی اصلی یا سوئیچ هسته شبکه در ساعات کاری، سازمان را با اختلال سراسری مواجه می سازد. با جایگزینی به موقع قطعات در ساعات خاموشی و خارج از شیفت کاری، خطر شوک های ناگهانی به فرایندهای مالی و اداری به حداقل می رسد.
برنامه ریزی قطعات
تامین دیسک های رکمونت، ماژول های حافظه با ECC رجیستر و کنترلرهای اختصاصی سرور در زمان بحران ممکن است روزها طول بکشد. نگهداری پیشگیرانه امکان بررسی عمر مصرفی و تامین استوک پشتیبان را پیش از خرابی حتمی فراهم می سازد.
مدیریت ظرفیت
سخت افزارها تحت بار پردازشی و دمایی مداوم به تدریج دچار افت راندمان می گردند. بازبینی دوره ای میزان اشغال کش کنترلرها، ترافیک ورودی باس ها و ظرفیت پاورها مانع از فشار مضاعف بر مدارات تغذیه و جلوگیری از کندی محسوس سرویس ها می شود.
مستندسازی
ثبت تاریخ تعویض باتری های کنترلر، فریم ور های اعمال شده، ساعات کارکرد هر پاور و وضعیت سلامت آرایه های رید در دفترچه فنی شاسی ها باعث می شود رفع عیب در حوادث بعدی با آگاهی کامل از پیشینه دستگاه ها و بدون آزمون و خطا انجام شود.
افزایش قابلیت پیش بینی
به جای مواجهه غیرمنتظره با توقف زیرساخت و تحمیل هزینه های پیش بینی نشده ارزی، گزارش های منظم سلامت فیزیکی به مدیریت سازمان اجازه می دهد بودجه های ارتقا یا تعویض سخت افزار را از ماه ها قبل در جریان مالی سازمان پیش بینی کند.
برندها و تجهیزات قابل پشتیبانی
پوشش خدمات سخت افزاری سازمان به حوزه هایی محدود است که مستندات، ابزارهای عیب یابی تخصصی و دسترسی به قطعات یدکی استاندارد آنها در دسترس باشد.
عیب یابی و نگهداری تخصصی سرورهای پرولیانت سری های DL و ML، کنترلرهای اسمارت اری، منابع تغذیه ریداندنت و خواندن خطاهای سنسورها از طریق محیط مدیریتی ILO.
پشتیبانی فنی ایستگاه های کاری، عیب یابی بردهای سروری و اداری ایسوس، تعمیر مدارات تغذیه پردازنده و نگهداری سیستم های پردازشی دسکتاپ و آل این وان سازمانی.
سرویس فیزیکی دستگاه های کیونپ سازمانی، مدیریت سلامت دیسک ها در شاسی های کیونپ، عیب یابی بردهای بک پلن دیسک، تعویض فن ها و ماژول های تغذیه ذخیره ساز.
نگهداری شاسی های سروری سوپرمیکرو، رفع خطاهای پاور و توزیع برق، تعویض مادربردهای اختصاصی سرور، مدیریت خنک سازی رک و بررسی گزارش های خطا در پنل IPMI.
سوالات متداول تعمیر و نگهداری سخت افزار
پاسخ های مستقیم و فنی به پرسش های رایج مدیران IT و سازمان ها پیرامون عیب یابی، تعمیر، برآورد هزینه و نگهداری تجهیزات کامپیوتری و سرورها.